Che cosa succede su Google se chiudi una cartella del tuo sito
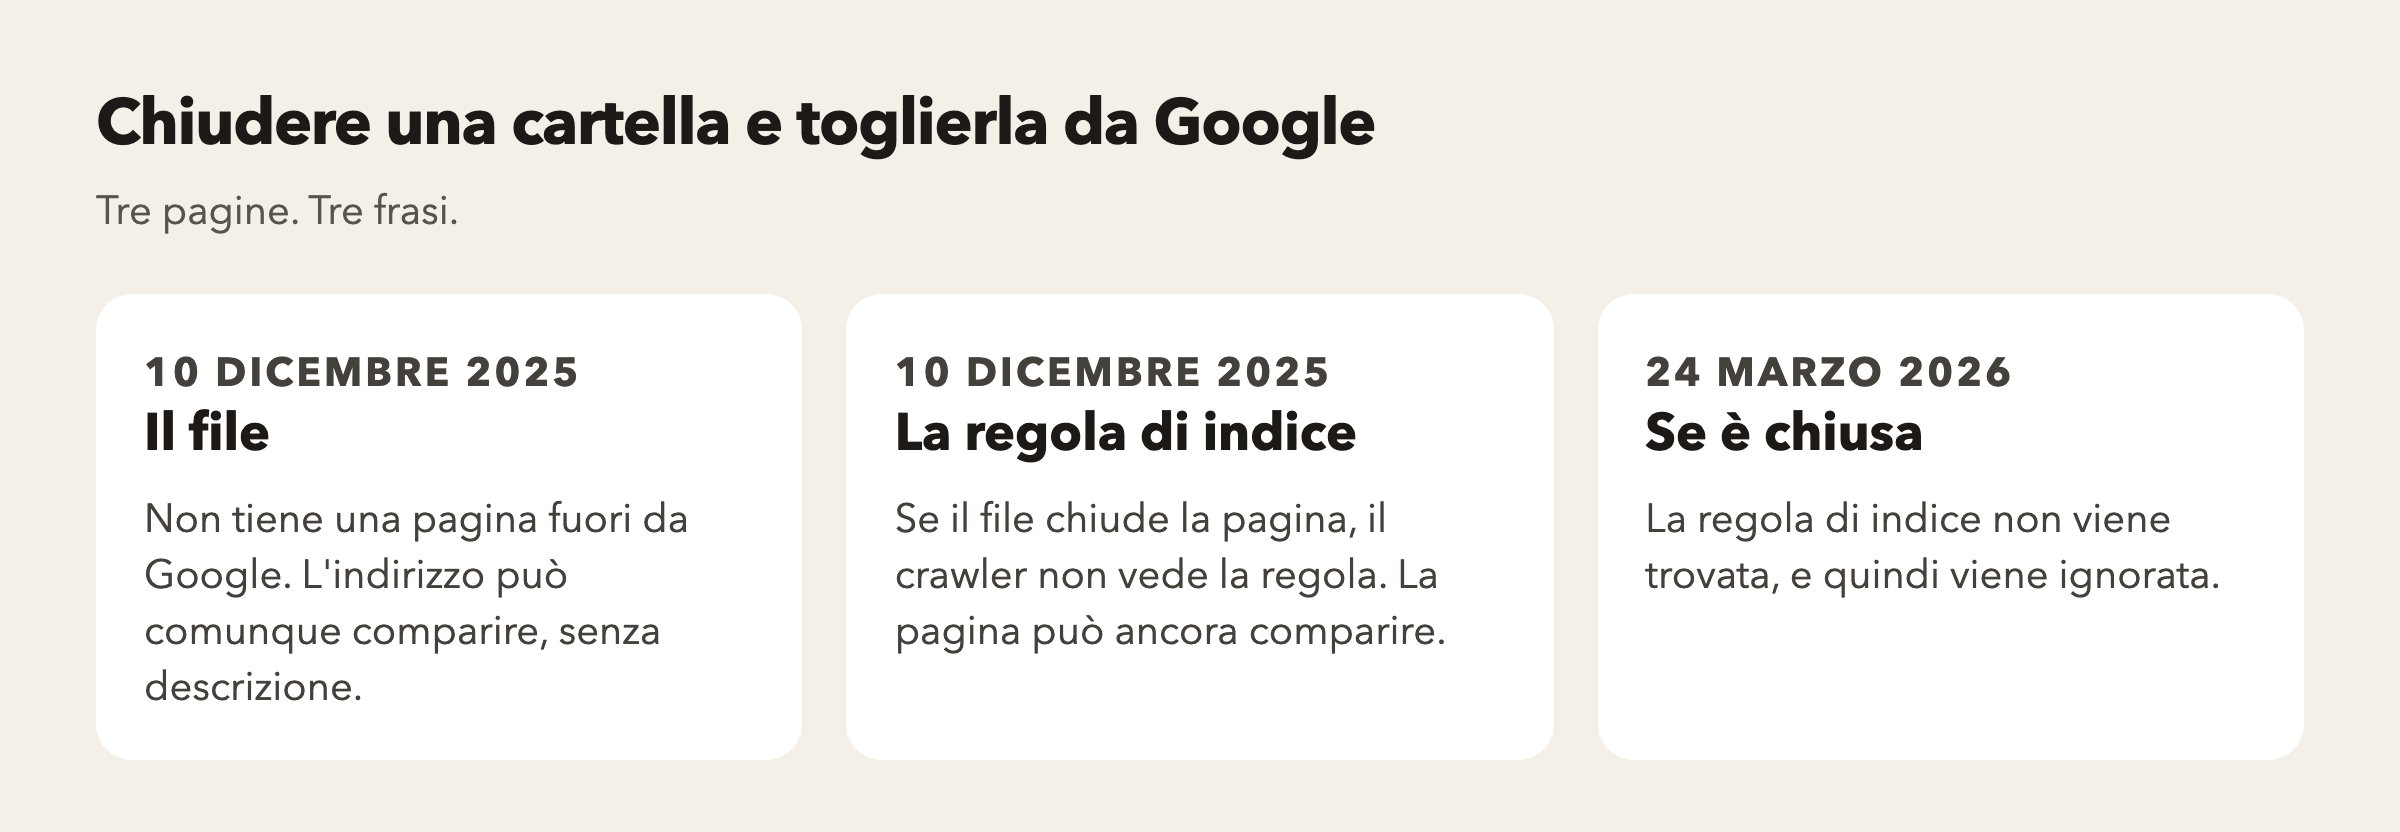
La pagina del 10 dicembre 2025 dice che il file non tiene una pagina fuori da Google. La pagina del 24 marzo 2026 dice che, se è chiusa, noindex viene ignorato.
In questa guida (8)
Se chiudi una cartella del tuo sito, la domanda è che cosa succede su Google: il crawler smette di entrarci, oppure la pagina esce dall'indice. Il 3 novembre 2026 ho letto l'introduzione del 10 dicembre 2025, la pagina sulla regola di indice dello stesso giorno, la pagina del meta del 24 marzo 2026, la specifica di Google del 23 ottobre 2026 e la RFC 9309 del settembre 2022. Non dicono la stessa cosa. Non ho misurato un sito.
L'introduzione, 10 dicembre 2025
La pagina Introduction to robots.txt ha last-modified 10 dicembre 2025 alle 18:38:05 GMT. In pagina: ultimo aggiornamento 10 dicembre 2025 UTC. Il giorno coincide. Definisce il file come quello che dice ai crawler dei motori quali indirizzi possono raggiungere sul sito. Serve soprattutto a non sovraccaricare il sito di richieste. Poi scrive che non è un meccanismo per tenere una pagina fuori da Google. Per tenere una pagina fuori da Google, scrive, si blocca l'indicizzazione con noindex oppure si protegge la pagina con una parola d'ordine. Sono due strade nominate, e restano distinte dal file.
Più sotto, alla domanda su a che cosa serve, scrive che il file serve soprattutto a gestire il traffico dei crawler e, di solito, a tenere un file fuori da Google, a seconda del tipo di file. Questa frase e la frase precedente non vanno nella stessa direzione. Non le unisco. La tabella che segue le separa per tipo.
Per una pagina web, HTML, PDF o altri formati non mediali che Google sa leggere, il file serve a gestire il traffico di scansione se pensi che il server sarà sommerso dalle richieste del crawler di Google, oppure a non scandire pagine poco importanti o simili. L'avviso dice di non usare il file per nascondere le pagine web, compresi i PDF e gli altri formati di testo che Google supporta, dai risultati. Se altre pagine puntano alla tua con un testo descrittivo, Google potrebbe comunque indicizzare l'indirizzo senza visitare la pagina. Se vuoi bloccare la pagina dai risultati, usa un altro metodo, come la protezione con parola d'ordine o noindex. Se la pagina è bloccata dal file, l'indirizzo può ancora comparire nei risultati, ma il risultato non avrà una descrizione. Immagini, video, PDF e altri file non HTML incorporati nella pagina bloccata restano esclusi dalla scansione, a meno che altre pagine autorizzate alla scansione non li richiamino.
Per un file mediale la riga è un'altra. Il file serve a gestire il traffico di scansione e anche a impedire che immagini, video e audio compaiano nei risultati di Google. Questo non impedisce ad altre pagine o a delle persone di collegare quel file. Le guide su come togliere immagini e video non le ho aperte.
Per un file di risorsa, la pagina dice che puoi bloccare file poco importanti, come immagini, script o fogli di stile, se pensi che le pagine caricate senza quelle risorse non ne risentano in modo rilevante. Se invece l'assenza rende la pagina più difficile da capire per il crawler, non bloccarli. Non è la stessa riga della pagina web.
Poi elenca i limiti, e restano distinti. Le regole possono non essere supportate da tutti i motori. Le istruzioni non possono imporre il comportamento del crawler: sta al crawler obbedire. Googlebot e altri crawler rispettabili obbediscono. Altri possono non farlo. Per tenere un'informazione al sicuro dai crawler, è meglio un altro metodo, come proteggere con parola d'ordine i file privati sul server. Crawler diversi interpretano la sintassi in modo diverso. Una pagina chiusa nel file può comunque essere indicizzata se altri siti la collegano. In quella frase scrive che Google non scansiona né indicizza il contenuto bloccato dal file, e che può comunque trovare e indicizzare un indirizzo chiuso se è collegato da altri posti sul web. L'indirizzo e, potenzialmente, altre informazioni pubbliche, come il testo di ancoraggio dei link verso la pagina, possono comparire nei risultati. Per impedire davvero che l'indirizzo compaia, proteggere i file con parola d'ordine, usare il meta noindex o l'intestazione di risposta, oppure togliere la pagina del tutto. Non scandire il contenuto, e indicizzare lo stesso l'indirizzo, sono due pezzi della stessa pagina. Non li fondo nel "il file toglie la pagina" né nel "il file non fa nulla".
Una nota dice che combinare più regole di scansione e di indice può far sì che alcune regole annullino le altre. Quella spiegazione sta sulla pagina del meta, e la leggo sotto come pagina sua. La guida per limitare il ritmo di scansione non l'ho aperta. Non ho copiato esempi di righe.
La regola noindex, ancora 10 dicembre 2025
La pagina Block Search indexing with noindex ha lo stesso last-modified, 10 dicembre 2025 alle 18:38:05 GMT. In pagina: ultimo aggiornamento 10 dicembre 2025 UTC. Il giorno coincide. È un'altra pagina. Definisce noindex come una regola messa o con un meta o con un'intestazione di risposta HTTP, usata per impedire l'indicizzazione del contenuto dai motori che supportano la regola, per esempio Google. Quando Googlebot scansiona quella pagina ed estrae il meta o l'intestazione, Google toglie quella pagina per intero dai risultati, a prescindere dal fatto che altri siti la colleghino. Questa frase, "a prescindere dai link", non è la frase dell'introduzione, che parla di un indirizzo chiuso dal file e che può comparire proprio perché altri lo collegano. Sono due casi.
Il punto importante dice che, perché noindex sia efficace, la pagina o la risorsa non deve essere bloccata dal file, e deve essere altrimenti raggiungibile dal crawler. Se la pagina è bloccata dal file, o il crawler non può raggiungerla, il crawler non vedrà mai la regola, e la pagina può ancora comparire nei risultati, per esempio se altre pagine la collegano. "Non vedrà mai la regola" sta su questa pagina. Non è ancora la frase del 24 marzo, che parla di regole ignorate.
Scrive che indicare la regola noindex dentro il file robots.txt non è supportato da Google. Due modi di metterla, meta e intestazione, hanno lo stesso effetto. Si sceglie il modo più comodo per il sito e adatto al tipo di contenuto. Non ho copiato i marcatori. La guida passo passo per togliere un'informazione da Google, nominata dalla pagina del meta, non l'ho aperta.
La pagina del meta, 24 marzo 2026
La pagina sul meta robots e sull'intestazione X-Robots-Tag ha last-modified 24 marzo 2026 alle 12:42:32 GMT. In pagina: ultimo aggiornamento 24 marzo 2026 UTC. Il giorno coincide. Dice che il meta permette un approccio granulare, di pagina, per controllare come una singola pagina HTML vada indicizzata e servita nei risultati. noindex, nell'elenco delle regole, significa non mostrare questa pagina, questo media o questa risorsa nei risultati. Se non indichi la regola, la pagina, il media o la risorsa possono essere indicizzati e mostrati. Un'altra voce, none, equivale a noindex insieme a nofollow. Non la fondo con noindex da sola. In caso di regole in conflitto, si applica la regola più restrittiva. È una frase sulle regole robots in conflitto fra loro. Non è la frase sulla cartella chiusa.
La sezione sul combinare il file con le regole di indice e di servizio dice che i meta e le intestazioni X-Robots-Tag si scoprono quando un indirizzo viene scandito. Se una pagina è esclusa dalla scansione attraverso il file, ogni informazione sulle regole di indice o di servizio non verrà trovata e quindi verrà ignorata. Se quelle regole devono essere seguite, gli indirizzi che le contengono non possono essere esclusi dalla scansione. "Ignorata" è la parola di questa pagina. "Non verrà mai vista" è la parola della pagina del 10 dicembre. Non le unisco. Gli esempi di configurazione di quella sezione non li ho copiati.
La RFC 9309, settembre 2022
La RFC 9309, Robots Exclusion Protocol, non ha last-modified. Il testo è del settembre 2022. Specifica ed estende il metodo definito da Martijn Koster nel 1994, perché chi gestisce un servizio controlli come il contenuto possa essere raggiunto, se mai, da client automatici chiamati crawler. Aggiunge il linguaggio di definizione, la gestione degli errori e la cache. Nell'introduzione scrive che queste regole non sono una forma di autorizzazione all'accesso. Nella sezione sulla sicurezza, un'altra frase, scrive che il protocollo non è un sostituto di misure di sicurezza valide sul contenuto. Elencare i percorsi nel file li espone in pubblico e quindi li rende scopribili. Per controllare l'accesso a quei percorsi, gli utenti del protocollo dovrebbero usare una misura di sicurezza valida per lo strato applicativo su cui il file è servito. L'esempio è l'autenticazione HTTP definita nella RFC 9110. Quella RFC non l'ho aperta. Non descrivo come si imposta. Autorizzazione, e sostituto di una misura di sicurezza, restano due frasi. Non le fondo con "non è un meccanismo per tenere una pagina fuori da Google", che sta sull'introduzione di Google.
Allow e Disallow indicano se l'accesso a un URI che corrisponde al percorso è permesso o no. Il crawler deve confrontare i percorsi delle regole con l'URI. Il confronto dovrebbe essere sensibile alle maiuscole. Deve partire dal primo ottetto del percorso. Si deve usare la corrispondenza più specifica, quella con più ottetti. Se una regola allow e una disallow sono equivalenti, si dovrebbe usare allow. Se nel gruppo non c'è corrispondenza, o il gruppo non ha regole, l'URI è permesso. L'URI del file è implicitamente permesso. Gli esempi della RFC usano caratteri jolly. Non li incollo.
Sulla cache, i crawler possono tenere il contenuto del file. Possono usare il controllo di cache ordinario definito nella RFC 9111. Non l'ho aperta. Non dovrebbero usare la versione in cache per più di 24 ore, a meno che il file sia irraggiungibile. Il limite di analisi deve essere almeno 500 kibibyte. Queste frasi sono della RFC. La pagina di Google sulla cache la leggo a parte.
Come Google legge il file, 23 ottobre 2026
La pagina How Google interprets the robots.txt specification ha last-modified 23 ottobre 2026 alle 14:07:37 GMT. In pagina: ultimo aggiornamento 23 ottobre 2026 UTC. Il giorno coincide. Scrive che i crawler di Google confrontano le regole con gli indirizzi nella forma con la percentuale, come definito nella sezione 2.2.2 della RFC 9309, e trasformano da soli i percorsi scritti in UTF-8 grezzo in quella forma. Il file va nella directory di primo livello del sito, su un protocollo supportato. L'indirizzo del file, come gli altri indirizzi, è sensibile alle maiuscole. Per Google Search i protocolli supportati sono HTTP, HTTPS e FTP. Su HTTP e HTTPS i crawler scaricano il file con una richiesta non condizionale. Su FTP usano un recupero anonimo. I nomi dei comandi non li incollo. Le regole valgono solo per l'host, il protocollo e la porta dove il file è ospitato.
Per i percorsi, Google, Bing e altri motori grandi supportano una forma limitata di caratteri jolly. Uno indica zero o più caratteri validi. L'altro indica la fine dell'indirizzo. Nella tabella, un percorso che è solo la radice seguita dal primo jolly equivale alla radice, e il jolly finale viene ignorato. Un percorso che è la radice più il segno di fine corrisponde solo alla radice. Non incollo i segni né le altre righe della tabella.
Sull'ordine fra gruppi, per un crawler vale un solo gruppo. I crawler di Google scelgono il gruppo con l'agente più specifico che corrisponde al loro. Gli altri gruppi si ignorano. L'ordine dei gruppi nel file non conta. Se per uno stesso agente c'è più di un gruppo specifico, le regole di quei gruppi si combinano all'interno in un solo gruppo. I gruppi specifici e il gruppo globale non si combinano. La specificità dell'agente, su questa pagina, non è la specificità del percorso, che nella RFC è il numero di ottetti. Non le unisco. Nell'esempio della pagina una cartella è chiusa per il gruppo di tutti e aperta per Googlebot. Non incollo le righe.
Sugli errori, i crawler di Google trattano tutti gli errori 4xx, tranne il 429, come se un file valido non esistesse. Google assume che non ci siano restrizioni di scansione. Non usare i codici 401 e 403 per limitare il ritmo di scansione. Quei 4xx, tranne il 429, non hanno effetto sul ritmo. La guida per limitare il ritmo non l'ho aperta. La pagina di questo sito sul 429 non la riscrivo.
Se Google trova il file ma non riesce a scaricarlo, per le prime 12 ore smette di scandire il sito e continua a provare il file. Se non riesce a ottenere una versione nuova, per i 30 giorni successivi usa l'ultima versione buona, e continua a provare. Un 503 porta a tentativi piuttosto frequenti. Se non c'è una versione in cache, Google assume che non ci siano restrizioni. Se dopo 30 giorni gli errori restano, due casi restano distinti. Se il sito è in generale raggiungibile da Google, Google si comporta come se il file non ci fosse, e continua a controllare se ne arriva uno. Se il sito ha problemi generali di raggiungibilità, Google smette di scandire il sito e continua a chiedere il file di tanto in tanto. Errori di DNS o di rete, timeout, risposte non valide, connessioni interrotte, sono trattati come errore del server.
Sulla cache, Google in generale tiene il contenuto del file fino a 24 ore, ma può tenerlo di più quando non riesce ad aggiornare la copia, per esempio per timeout o errori 5xx. Può allungare o accorciare la vita in base all'intestazione max-age. Fino a 24 ore, sulla pagina di Google, e non più di 24 ore a meno che il file sia irraggiungibile, sulla RFC, restano due scritti. I 30 giorni sono la frase sugli errori, non la frase della cache.
Che cosa non rimetto
La pagina sulla migrazione, già online, dice di togliere noindex e i blocchi nel file che servivano solo durante la preparazione, e che se il file non esiste la guida chiede un 404 corretto. Non ho riaperto quella guida. Non riscrivo la pagina sulla migrazione. Non è questa pagina: qui la domanda è la differenza fra chiudere una cartella e togliere la pagina dall'indice.
Non ho copiato righe di esempio, grammatiche, né configurazioni. Non ho descritto come si mette una parola d'ordine. Le pagine dicono che il file non è quella protezione. Elencare un percorso nel file lo rende scopribile: è la frase della RFC, non un invito a pubblicare un percorso riservato.
Esempio ipotetico
prova.bottega.example è un nome di scuola, una copia di prova. Non ho aperto quel nome e non ho letto un suo file.
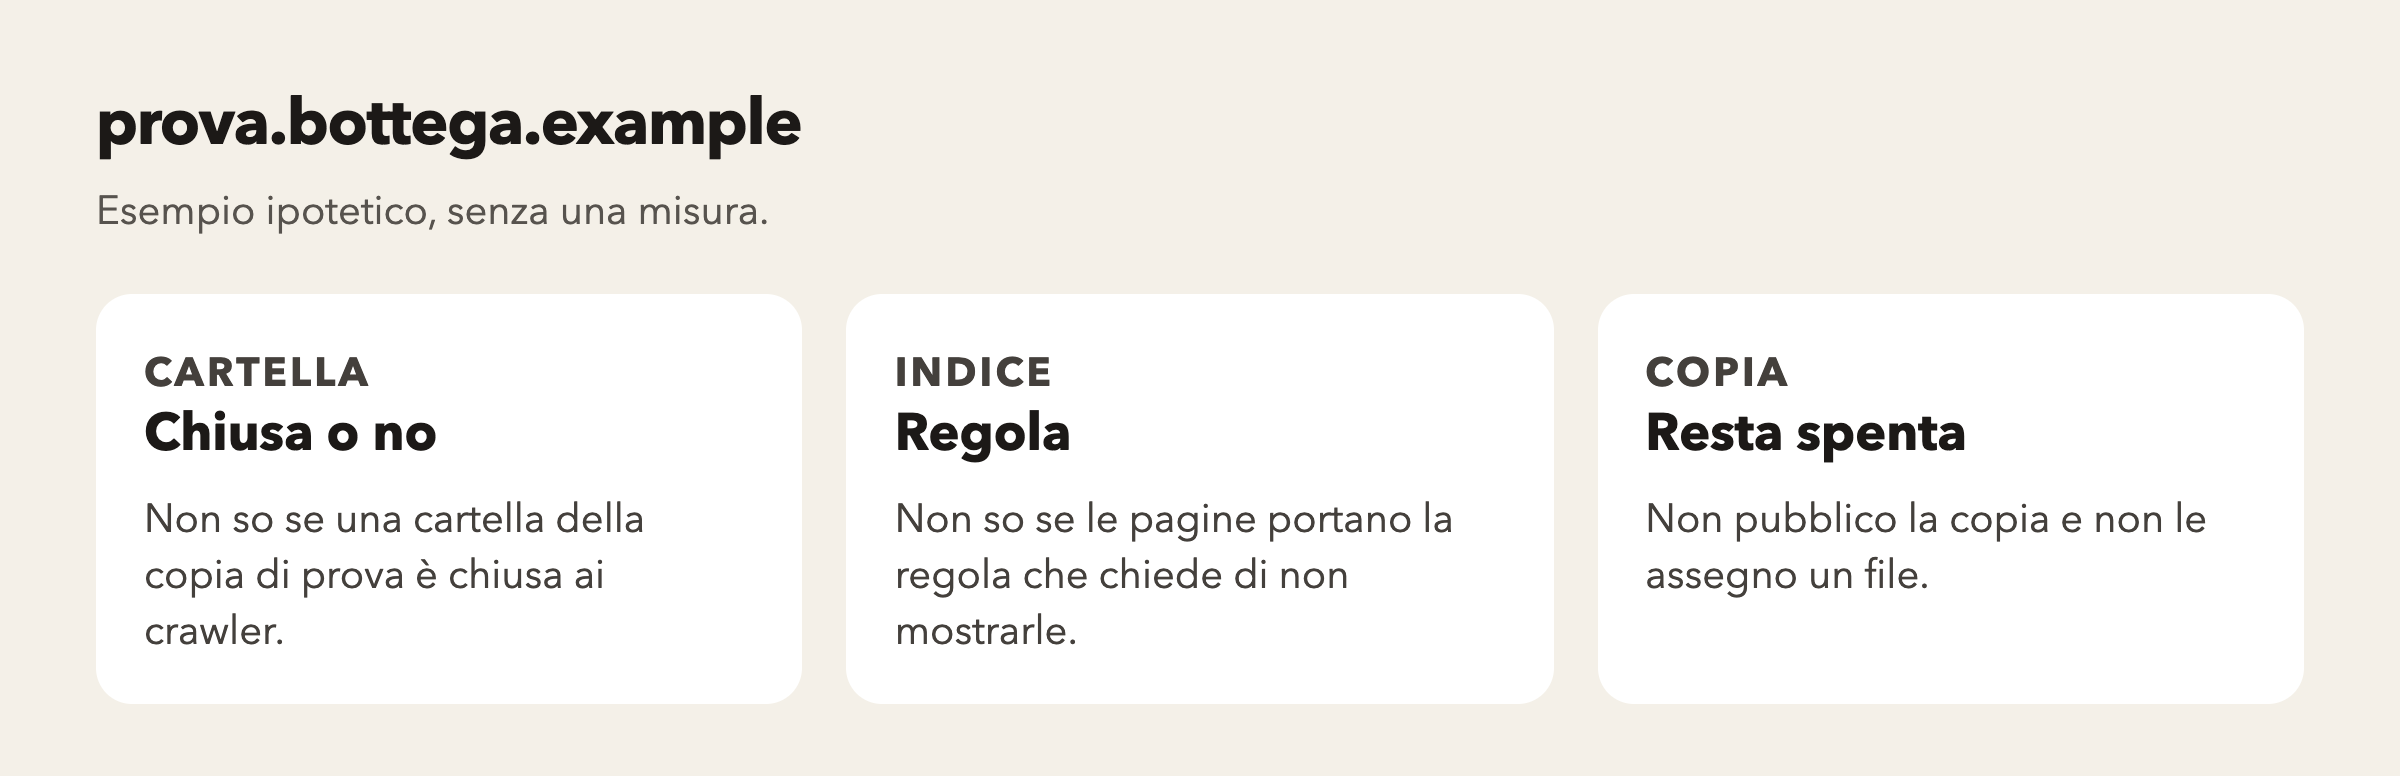
Non le assegno una cartella chiusa, una regola noindex, un 429, un 503, 12 ore, 30 giorni, né 24 ore di cache. Non la pubblico, perché non l'ho misurata.
Che cosa questa pagina lascia stare
Non ho aperto le guide per togliere immagini e video, la guida sul ritmo di scansione, la RFC 9110, la RFC 9111, la guida passo passo per togliere un'informazione da Google, e la pagina sulle misure del sito. Non ho riscritto la pagina sulla migrazione né la pagina sul 429. Non ho misurato un sito. La copertina di questa pagina è nuova, perché la pagina è nuova.
Fonti lette il 3 novembre 2026. Introduction to robots.txt, last-modified 10 dicembre 2025 alle 18:38:05 GMT, ultimo aggiornamento in pagina 10 dicembre 2025 UTC, https://developers.google.com/search/docs/crawling-indexing/robots/intro. Block Search indexing with noindex, last-modified 10 dicembre 2025 alle 18:38:05 GMT, ultimo aggiornamento in pagina 10 dicembre 2025 UTC, https://developers.google.com/search/docs/crawling-indexing/block-indexing. Robots meta tag e X-Robots-Tag, last-modified 24 marzo 2026 alle 12:42:32 GMT, ultimo aggiornamento in pagina 24 marzo 2026 UTC, https://developers.google.com/search/docs/crawling-indexing/robots-meta-tag. How Google interprets the robots.txt specification, last-modified 23 ottobre 2026 alle 14:07:37 GMT, ultimo aggiornamento in pagina 23 ottobre 2026 UTC, https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec. RFC 9309, settembre 2022, senza last-modified, https://www.rfc-editor.org/rfc/rfc9309.txt.