Perché la pagina del tuo sito carica file che non hai scelto
La pagina del tuo sito può caricare un file che non hai scelto. Una riga sulla risposta dice al browser quali indirizzi sono ammessi.
In questa guida (8)
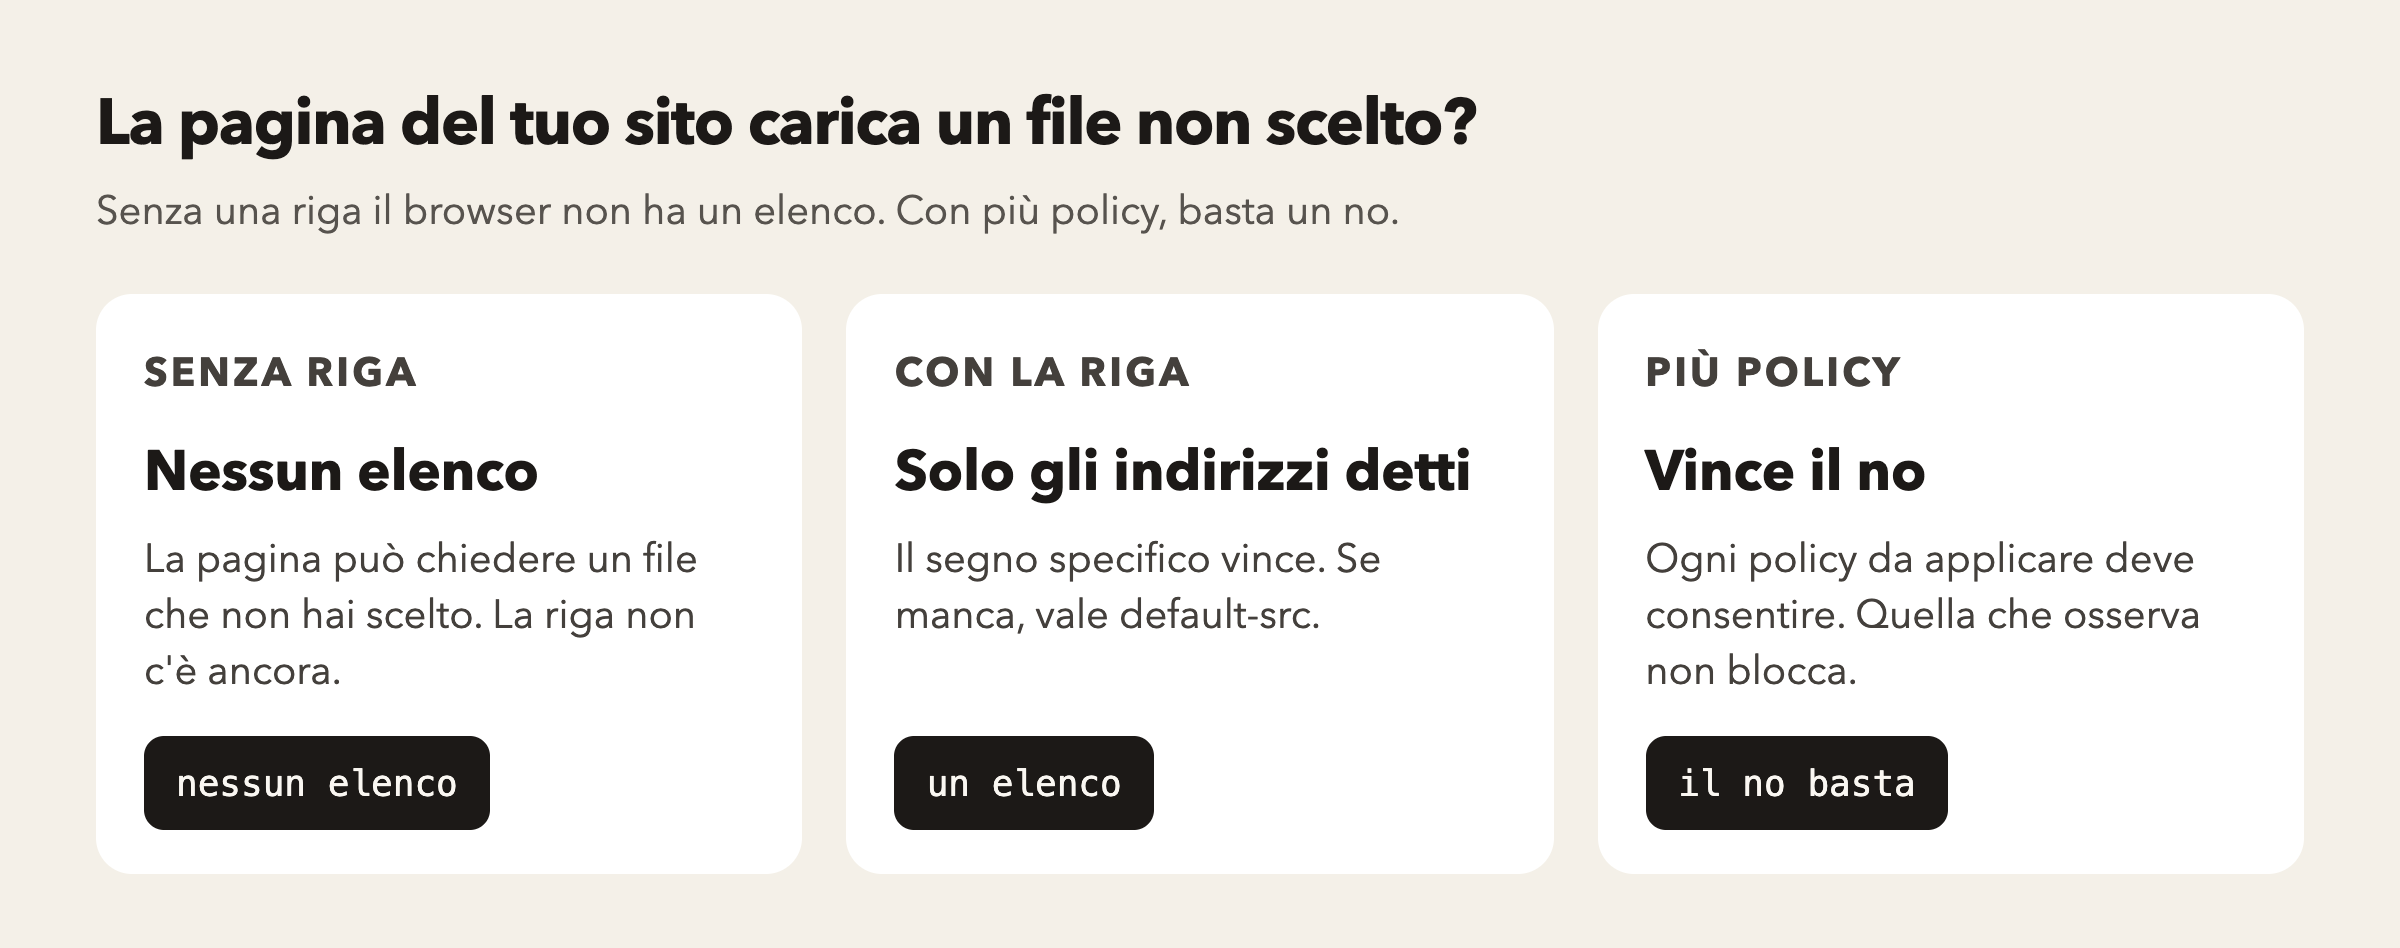
La pagina del tuo sito può caricare un file che non hai scelto: uno script, un foglio, una foto, un frame. Senza una riga sulla risposta, il browser non ha un elenco di indirizzi ammessi. Il nome della riga è Content-Security-Policy. La sigla che si legge in giro è CSP. Il 2 novembre 2026 ho letto la bozza W3C Content Security Policy Level 3, Working Draft del 27 ottobre 2026, e la pagina MDN su questo header, ultima modifica 22 marzo 2026. La bozza non è una Recommendation. Dice di essere un'iterazione del livello 2. Non ho aperto il livello 2. Non ho misurato un browser.
La sezione 1, non normativa, dice che questo meccanismo è una difesa in profondità. Riduce il danno di un contenuto inserito nella pagina. Non è la prima linea e non sostituisce il controllo di ciò che entra e di ciò che la pagina scrive. Non descrivo quei passi. Questa pagina non riscrive quella sul file in chiaro, né quella che tiene il browser sul canale sicuro, né quella sui cookie, né quella sul frame. Non le ho riaperte per riscriverle.
Che cosa la riga decide
La sezione 1.2 elenca gli scopi: quali risorse la pagina può chiedere ed eseguire, il codice scritto dentro la pagina, l'esecuzione dinamica, lo stile scritto dentro la pagina, chi può incorporare la risorsa, e un modo per segnalare le violazioni. La sezione 2.2 dice che una policy ha un insieme ordinato di direttive, una disposizione che è enforce oppure report, e una sorgente che è header oppure meta. Più policy possono valere sulla stessa risorsa. La lista tiene anche l'origine usata per il confronto con 'self'.
La sezione 2.4 descrive una violazione: ha un indirizzo, uno status, una risorsa, la policy violata, la disposizione, la direttiva efficace. La risorsa può essere un indirizzo, oppure le parole inline, eval, wasm-eval, trusted-types-policy, trusted-types-sink. La nota dice che il campione, se c'è, sono i primi 40 caratteri di uno script interno, di un gestore o di uno stile, e che un file esterno non porta un campione. L'algoritmo della sezione 4.2.3 scrive quei 40 caratteri solo se la direttiva contiene 'report-sample'. La nota della sezione 2.4 non nomina quella condizione. MDN la nomina, nella stessa forma dell'algoritmo. Non ho unito la nota e l'algoritmo.
Come la riga arriva al browser
La sezione 3 dice che il server può dichiarare la policy con un header, oppure dentro il documento con un elemento meta. La sezione 3.1: l'header Content-Security-Policy è il modo preferito. Il valore è una lista di una o più policy serializzate. La sezione 2.1 definisce la lista come un elemento, poi spazio facoltativo, una virgola, spazio facoltativo, un altro elemento. Non ho aperto RFC 9110, da cui quella regola di lista è presa, con una modifica sullo spazio. Quando il browser riceve l'header deve analizzare e applicare ogni policy della lista. Rappresentazioni diverse della stessa risorsa possono portare valori diversi.
La sezione 3.2: l'header Content-Security-Policy-Report-Only sorveglia e non applica. Il browser deve analizzare e monitorare ogni policy. La nota dice che questo header non è ammesso dentro un elemento meta. La sezione 3.3: un documento può portare la policy con uno o più elementi meta il cui attributo http-equiv corrisponde, senza distinzione di maiuscole ASCII, alla stringa Content-Security-Policy. Dentro il meta non sono ammessi nemmeno report-uri, frame-ancestors e sandbox. La policy del meta non si applica a ciò che la precede, compresi i file già chiesti dall'header Link e gli elementi link e script che stanno prima. Una modifica dell'attributo content dopo l'analisi è ignorata. La policy del meta si applica insieme alle altre. Non ho aperto il trattamento HTML di questo http-equiv.
I nomi delle direttive non distinguono le maiuscole. La nota della sezione 2 dice che due grafie diverse di script-src con 'none' sono equivalenti.
L'elenco, e il segno che manca
La sezione 6.1: le direttive di fetch controllano da dove si caricano certi tipi di risorsa. default-src è il ripiego. Se c'è, ogni direttiva di fetch non scritta usa quel valore. Se script-src è scritto, default-src non influenza le richieste di script. Non c'è eredità nel senso opposto. Gli hint come prefetch e preconnect, se default-src manca, sono sempre permessi: la stessa sezione dice che non sono legati a una direttiva di fetch e, senza quel ripiego, non hanno un elenco. Rimanda alla sezione 8.6, che non ho letto per intero.
script-src limita da dove gli script possono essere eseguiti, compresi i blocchi interni. Fa da ripiego per le destinazioni simili allo script, e per i worker se worker-src manca. La sezione dice che, se non serve il dettaglio, va usato al posto di script-src-attr e script-src-elem. Governa sei cose. Le richieste e le risposte di script passano dai controlli. I blocchi interni sono bloccati salvo che ogni policy li consenta: o perché non c'è né script-src né default-src, o perché c'è 'unsafe-inline', o un nonce, o un'impronta che coincide. 'unsafe-eval' e 'trusted-types-eval' stanno davanti a eval, a Function, e a setTimeout e setInterval quando il primo argomento non è chiamabile. La nota dice che i punti non standard, se il browser li ha, dovrebbero avere lo stesso vincolo. Non ho misurato un browser.
La sezione 1.3, nel riassunto dei cambiamenti rispetto al livello 2, dice che frame-src non è più deprecato e, se manca, ripiega su child-src e poi su default-src. worker-src è stato aggiunto e ripiega su child-src, poi su script-src, poi su default-src. È stato aggiunto manifest-src. Non ho aperto il livello 2, quindi non confronto il testo vecchio: riporto ciò che questa bozza dice di aver cambiato.
MDN, il 22 marzo 2026, elenca anche fenced-frame-src e prefetch-src. Nel testo della bozza del 27 ottobre 2026 quei due nomi non li ho trovati. MDN chiama deprecata block-all-mixed-content. La bozza, sezione 6.6, dice che quel nome è definito in un altro documento, e lo stesso per upgrade-insecure-requests, la cui scheda bibliografica è dell'8 ottobre 2015. Non ho aperto quei documenti e non ho unito le pagine. La pagina sul file in chiaro non è stata riscritta.
Quali indirizzi coincidono
La sezione 2.3.1 descrive le espressioni: 'none' non coincide con nulla, 'self' con l'origine dell'indirizzo corrente, uno schema come https con due punti, un host, un nonce, un'impronta. L'elenco è separato da spazi. 'none' da solo non coincide con nessun indirizzo. La sezione 6.7.2.7 dice che una direttiva senza valore equivale a 'none', e che 'none' non ha effetto se nell'elenco ci sono altre espressioni.
Il carattere il cui codice è U+002A, da solo, nella sezione 6.7.2.8 coincide se lo schema dell'indirizzo è HTTP o HTTPS, oppure se è lo stesso schema dell'origine protetta. La nota dice che uno schema che non è HTTP o HTTPS va scritto esplicitamente, salvo che la risorsa protetta usi già quello schema. Nel confronto host, sezione 6.7.2.10, se l'host non è un dominio il risultato è che non coincide, prima ancora di guardare il modello. Se il modello è quel solo carattere, coincide. Se il modello inizia con quel carattere e un punto, il resto, in minuscolo, deve essere la fine dell'host. La nota dice che la relazione non è simmetrica: il modello con il prefisso può coincidere con un nome sotto, e il nome sotto non coincide con il modello. Non ho scritto quel carattere nella pagina.
La sezione 6.7.2.9: lo schema http coincide con https, e non il contrario. ws coincide con wss, http e https. wss coincide con https. La nota dice che un'espressione https non coincide con un indirizzo http, e che si permette il passaggio dal non sicuro al sicuro. 'self', sezione 6.7.2.8, non coincide con lo schema blob. Coincide se le origini sono le stesse, oppure se l'host è lo stesso e le porte sono uguali o sono le porte di default degli schemi, e inoltre lo schema dell'indirizzo è https o wss, oppure l'origine è http e lo schema dell'indirizzo è http o ws. La nota limita questi passaggi alla porta di default o alla porta dell'origine. La sezione 1.3 dice che 'self' ora coincide con le varianti https e wss anche su una pagina il cui schema è http. È la stessa direzione. Non ho aperto la definizione di porta di default.
La nota della sezione 2.3.1 dice che un indirizzo IP entra nella grammatica ma, tra gli IP, solo 127.0.0.1 coincide davvero con un URL. L'algoritmo host che ho letto rifiuta un host che non è un dominio. Non ho aperto la definizione di dominio, quindi non decido se 127.0.0.1 sia un dominio. Lascio le due frasi separate. I nomi internazionali non si scrivono diretti: la sezione dice che vanno in Punycode. L'esempio della bozza è un nome con la u tedesca, scritto xn e due trattini. Non ho aperto RFC 3492.
Se l'espressione ha un path non vuoto e il conteggio dei redirect è zero, il path deve coincidere. Se il conteggio non è zero, quel controllo, in quel punto, non c'è. Ho letto l'inizio della sezione 6.7.2.12: un path vuoto coincide, e un path che è solo una barra coincide con un path vuoto. Non ho finito l'algoritmo. MDN dice che un path che finisce con la barra è un prefisso, e che un path che non finisce con la barra coincide per intero. Non confermo questa frase dalla bozza. Non ho letto la sezione 7.6 e non descrivo un uso di quel limite.
Il codice scritto nella pagina
La sezione 6.7.3.2: 'unsafe-inline' permette tutto il comportamento interno di quel tipo, salvo che l'elenco contenga un nonce o un'impronta, nel qual caso l'algoritmo risponde che non permette. Per i tipi script, attributo di script e navigazione, anche 'strict-dynamic' fa rispondere che non permette. MDN dice la stessa cosa per nonce e impronta: se ci sono, 'unsafe-inline' si ignora. Nel testo di MDN che ho letto, 'strict-dynamic' sta in un'altra frase: se c'è, si ignorano host, schema, 'self' e 'unsafe-inline', e la fiducia di un nonce o di un'impronta si estende agli script caricati dopo.
L'algoritmo delle richieste script, sezione 6.7.1.1, guarda prima il nonce e poi l'impronta. Se 'strict-dynamic' c'è, una richiesta inserita dal parser è bloccata, e una richiesta non inserita dal parser è permessa, e il confronto con l'elenco degli host non viene raggiunto. La sezione 8.2, non normativa, spiega l'uso e nomina dei modi per aggirare le liste di host. Non descrivo quei passi. Non ho unito la frase di MDN e l'ordine dell'algoritmo.
Il nonce, nella sezione 6.7.3.3, vale per script e stile interni, non per gli attributi e non per una navigazione con lo schema javascript. Il confronto è una stringa, non una decodifica. La sezione 6.7.3.1, prima di accettare il nonce di un elemento script, percorre gli attributi e rifiuta alcuni casi, ed è marcata come questione aperta. Non descrivo quei casi. L'impronta, nella sezione 1.3, può ora coincidere con uno script esterno se l'elemento indica metadati di integrità elencati nella policy. Non ho letto per intero la sezione 8.4. La pagina sull'impronta dei file esterni non è stata riscritta.
Più di una policy, e la segnalazione
La sezione 8.1, non normativa, dice che ogni policy va applicata o segnalata secondo il suo tipo. Nell'esempio, una policy nega una connessione e l'altra la permetterebbe: vince il no. Aggiungere una policy da applicare può solo restringere. Nell'algoritmo della sezione 4.2.3 il risultato diventa bloccato solo se la disposizione è enforce. Una policy report sorveglia. La sezione 3.2 descrive il passaggio: prima una policy che sorveglia, poi, quando il comportamento è noto, una policy applicata.
La sezione 1.3 dice che report-uri è deprecato in favore di report-to, che si appoggia a un altro documento. Non l'ho aperto. MDN dice che, nei browser che supportano report-to, report-uri è ignorato, e che finché il supporto non è ampio conviene mandarli entrambi. Non ho misurato un browser e non ho unito le due frasi. frame-ancestors limita quali pagine possono incorporare questa. La pagina sul frame è già pubblicata. Non la riscrivo e non ho letto il confronto della sezione 6.4.2.2.
Esempio ipotetico
bottega.example e fornitore.example sono nomi di scuola. Non ho letto una risposta di quei nomi. Non ho misurato un browser.
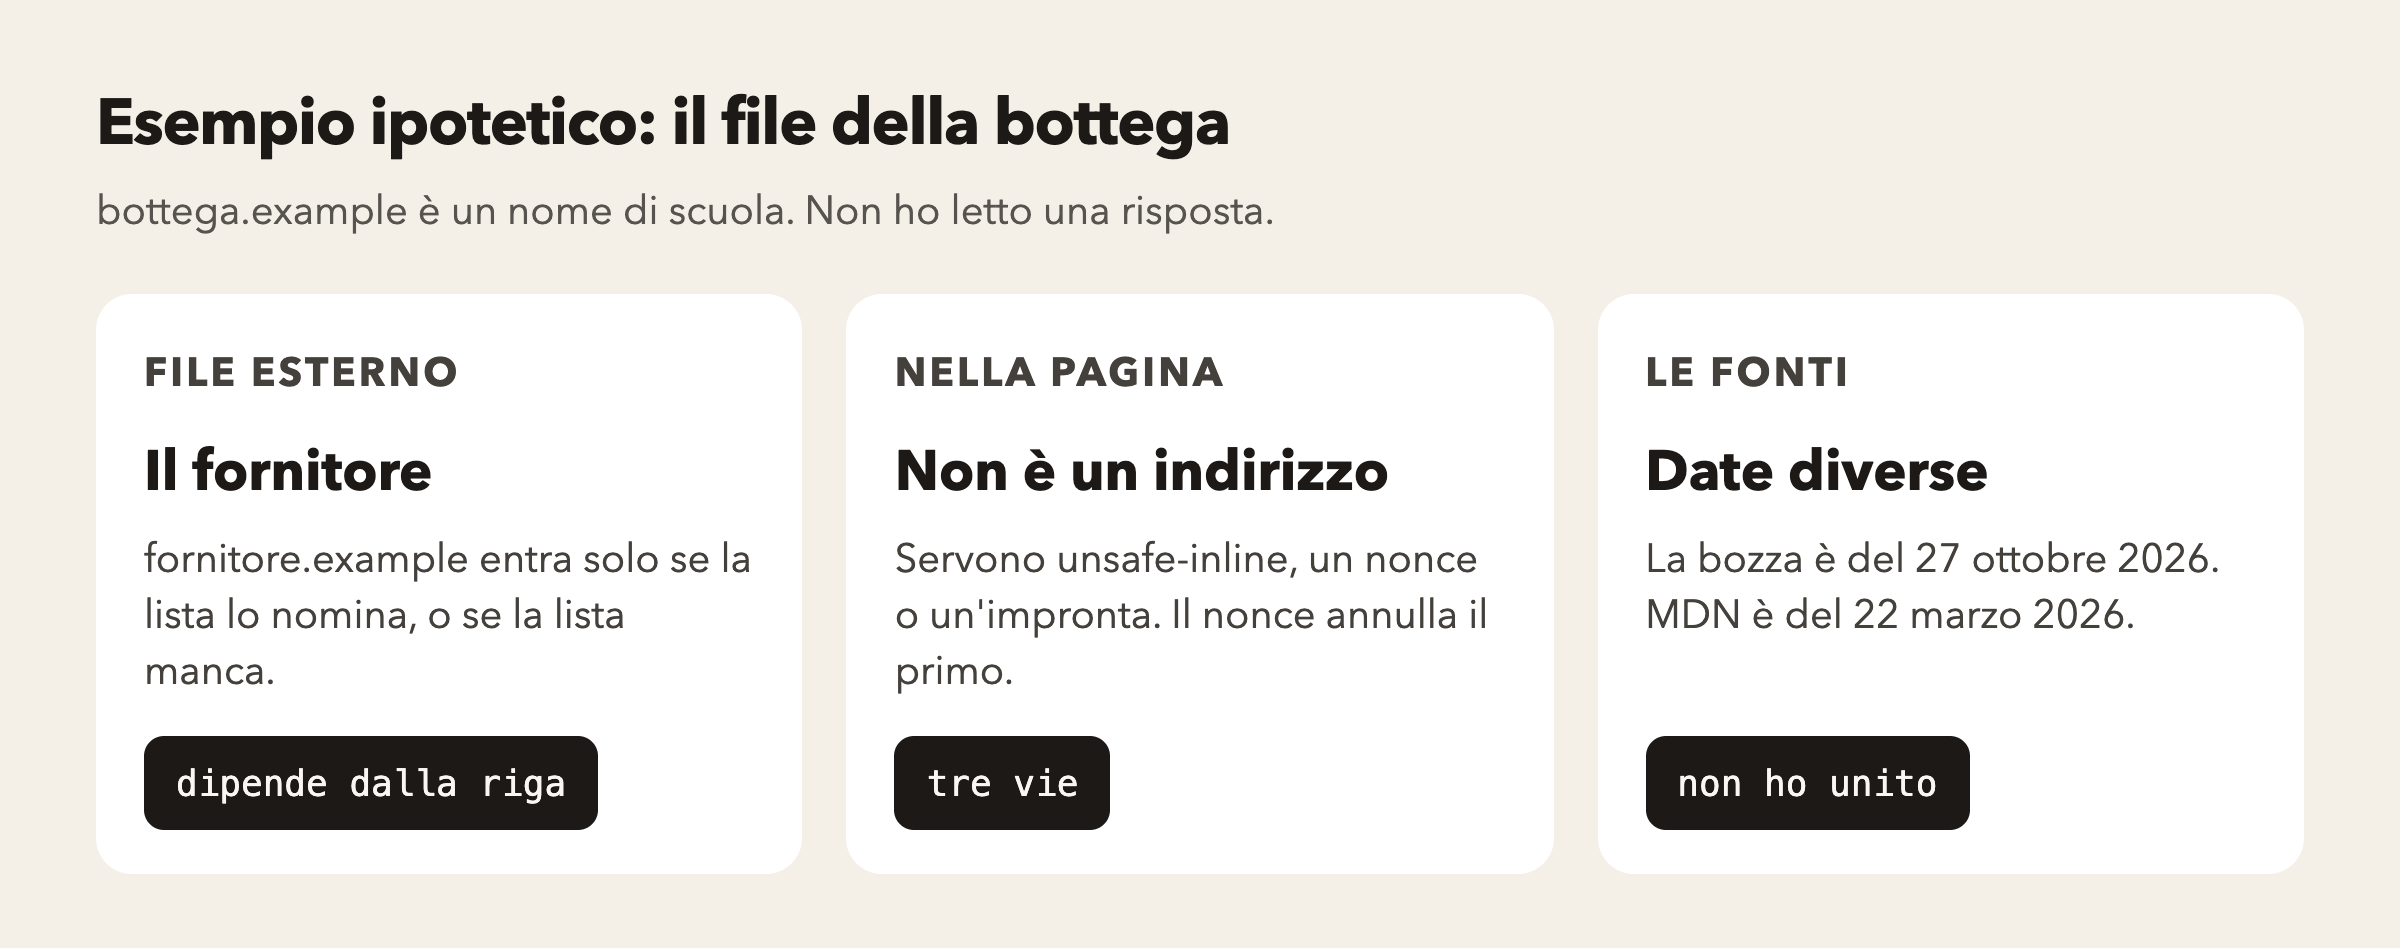
La pagina della bottega, senza la riga, può chiedere un file a fornitore.example. Con default-src uguale a 'none' e senza un script-src, quello script non coincide con nulla. Se script-src nomina fornitore.example, quello script può coincidere e un foglio resta su 'none', perché il segno specifico non eredita al contrario. Se la stessa risposta porta anche una seconda policy che non nomina fornitore.example, la sezione 8.1 dice che vince il no. Se la seconda policy è solo nell'header che sorveglia, la sezione 3.2 dice che non applica.
Un blocco scritto nella pagina non è un indirizzo. Serve 'unsafe-inline', oppure un nonce, oppure un'impronta. Se il nonce c'è, l'algoritmo della sezione 6.7.3.2 non lascia più passare tutto il codice interno. 'self', su una pagina http della bottega, può coincidere anche con https sullo stesso host, alle porte di default, secondo la sezione 6.7.2.8. Un indirizzo http non coincide con un'espressione che nomina solo https. MDN descrive gli stessi passaggi di schema. Non ho unito le pagine.
Che cosa questa pagina lascia stare
Non ho aperto il livello 2, né Fetch, né HTML, né RFC 9110, né RFC 3492, né il documento sul reporting, né quello sul contenuto misto, né quello che chiede di riscrivere gli indirizzi in chiaro, né la sezione 7 sui nonce oltre i titoli, né la sezione 7.6, né la sezione 8.4 per intero, né la sezione 8.6 per intero. Non ho misurato un browser. Non ho riscritto le pagine sul file in chiaro, sul canale sicuro, sui cookie, sul frame e sull'impronta. La copertina di questa pagina non è stata cambiata.
Fonti lette il 2 novembre 2026: bozza W3C Content Security Policy Level 3, 27 ottobre 2026, https://www.w3.org/TR/CSP3/ e la pagina MDN su Content-Security-Policy, ultima modifica 22 marzo 2026, https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Content-Security-Policy.