Quando il firewall del tuo sito giudica con regole o con un modello
Il firewall del tuo sito può fermare una richiesta con regole scritte, con un punteggio o con un modello. Il criterio non è lo stesso.
In questa guida (6)
Il firewall del tuo sito può fermare una richiesta, lasciarla passare, o limitarsi a scriverla. Il criterio con cui la giudica non è uno solo. Una regola scritta, un punteggio e un modello linguistico non vanno nella stessa direzione. Il 2 novembre 2026 ho riletto la pagina OWASP sul firewall applicativo, la pagina del Core Rule Set sull'anomaly scoring, e la pagina Cloudflare sull'attack score, aggiornata il 16 aprile 2026. Ho letto per intero, dall'API di arXiv, gli abstract di due paper. Non ho aperto i PDF. Non ho messo un modello in linea e non ho misurato il firewall di un sito.
La pagina su che cosa un firewall applicativo blocca e che cosa non risolve resta quella. Non l'ho riletta riga per riga oggi. Qui la domanda è un'altra: con quale criterio la richiesta viene giudicata. Il nome che si legge in giro è WAF. Sta nel testo, dopo il problema.
Che cosa fanno le regole
Il 2 novembre 2026 l'indirizzo vecchio della pagina OWASP risponde con un rimando. Il canonical che ho letto è community.owasp.org/Web_Application_Firewall. La pagina porta ancora l'avviso che il testo è stato portato in modo automatico dalla wiki precedente e che il lavoro di sistemazione non è finito. Cito il testo che c'è. Non lo tratto come uno standard chiuso. Non ho trovato, su quella pagina, una data di modifica distinta da questo avviso.
La pagina dice che un firewall applicativo per applicazioni HTTP applica un insieme di regole a una conversazione HTTP. In genere quelle regole coprono attacchi comuni. La pagina nomina due classi: contenuto inserito nella pagina, e iniezione SQL. Non descrivo le due classi. Un proxy, scrive la pagina, protegge di solito il client. Questo firewall protegge il server. La stessa pagina dice che può essere considerato un reverse proxy. Può stare su un appliance, su un plugin o su un filtro, e si personalizza sull'applicazione. Lo sforzo di quella personalizzazione può essere notevole e va mantenuto quando l'applicazione cambia. La pagina nomina anche tre progetti: il ruleset ModSecurity, Coraza e i criteri di valutazione WAFEC. Non ho aperto quelle tre schede.
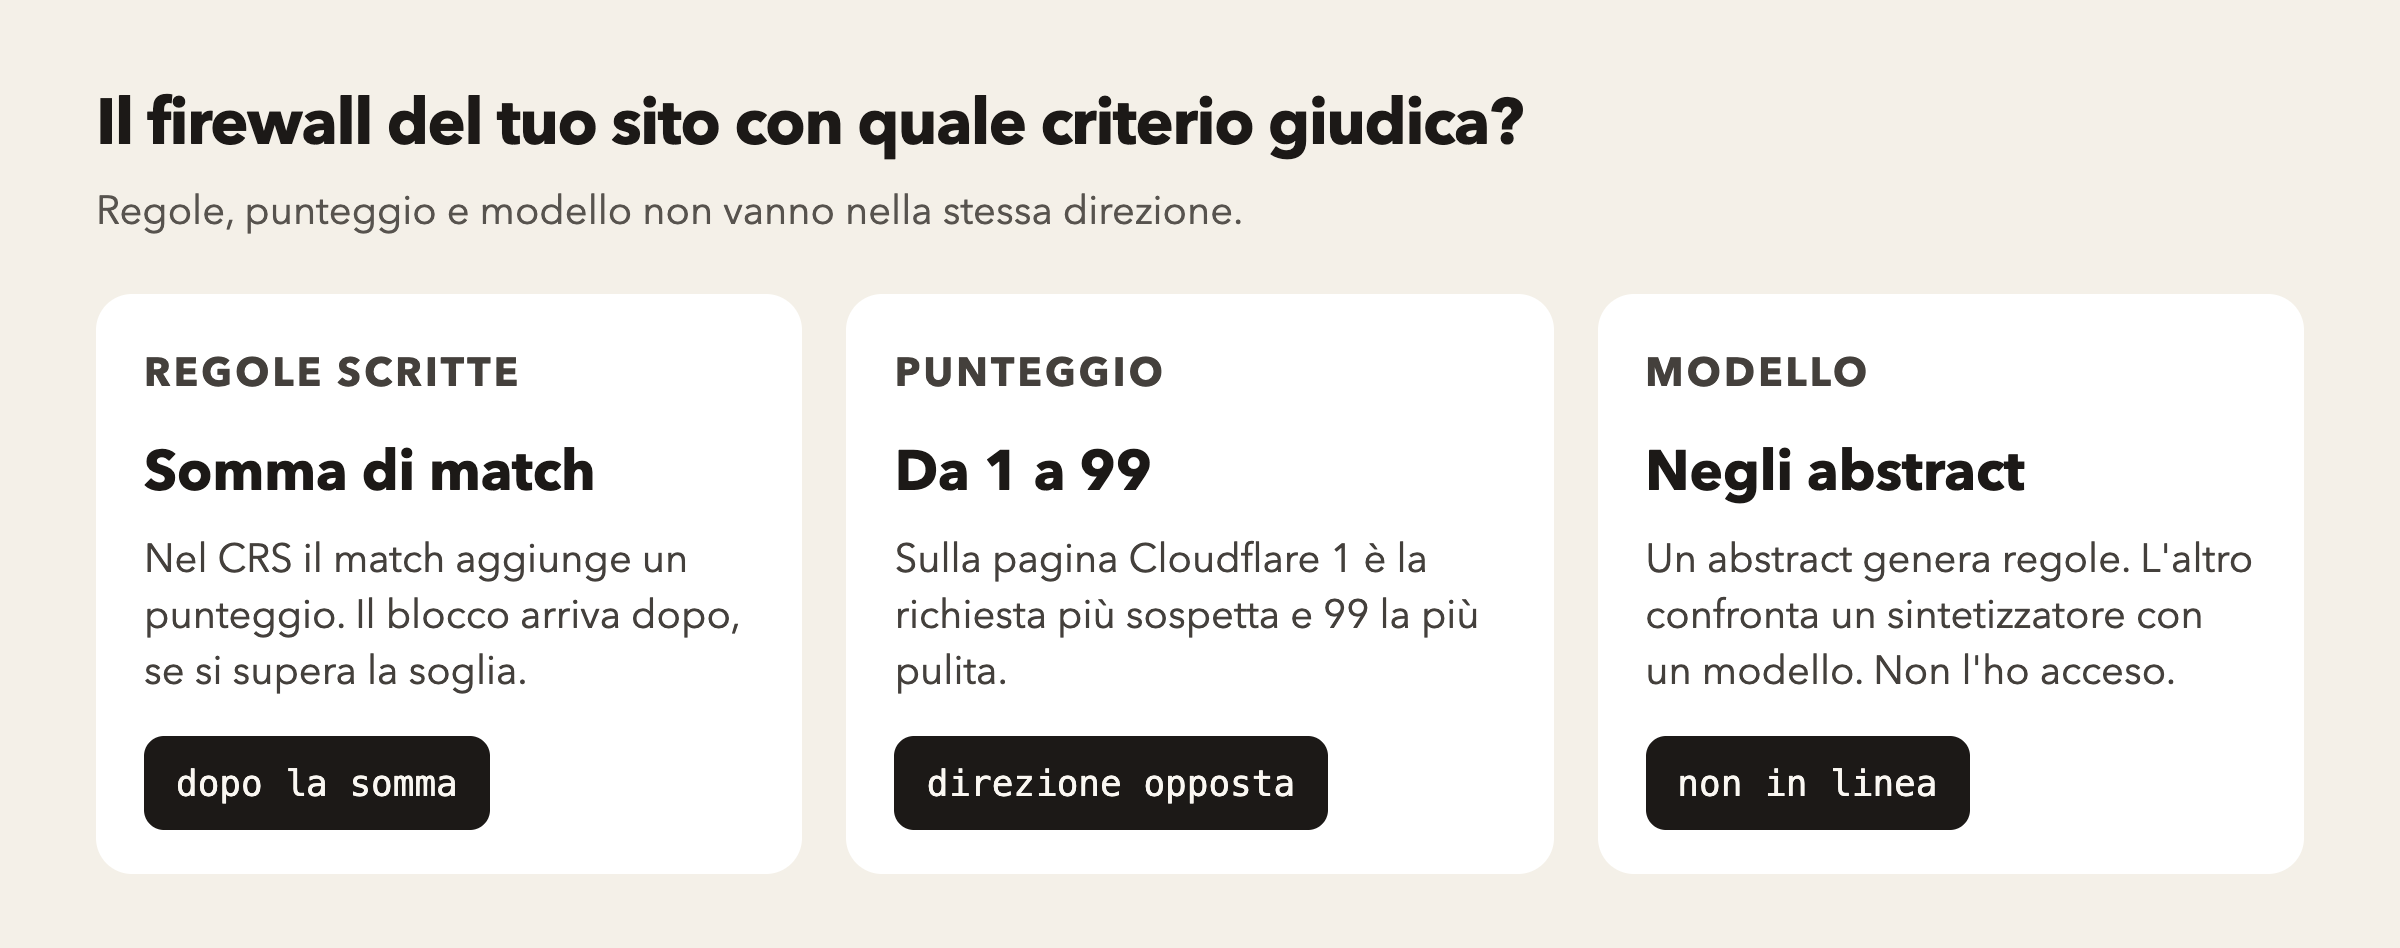
La pagina del Core Rule Set sull'anomaly scoring, letta lo stesso giorno, descrive ancora regole, non un modello. Non ho trovato una data di modifica. L'anomaly scoring, chiamato anche collaborative detection, assegna un punteggio numerico alla transazione HTTP, richiesta e risposta, per quanto appare anomala. La politica di blocco di default blocca la transazione che raggiunge o supera una soglia. Il rilevamento è staccato dal blocco. Se una regola combacia, non blocca subito. Aggiunge un punteggio e di solito scrive un log con l'id della regola, il dato che ha fatto match e l'URI. Quando le regole sulla richiesta hanno finito, si valuta il blocco in ingresso. Se il punteggio è almeno la soglia in ingresso, la transazione è rifiutata. Poi le regole sulla risposta. Se il punteggio in uscita raggiunge la sua soglia, la risposta non torna al visitatore. In quel caso, scrive la pagina, la richiesta è già stata gestita dall'applicazione: si ferma solo la risposta. I due punteggi restano separati.
La pagina mostra una regola di esempio che usa l'azione setvar di ModSecurity per alzare il punteggio. Non ho copiato la regola. I punteggi sono tenuti per livello di paranoia e sommati prima della valutazione. Non ho aperto la pagina su quel livello. Non ho letto la sezione sul blocco anticipato né la tabella delle severità.
Sulla soglia, la stessa pagina dice due cose che lascio distinte. La maggior parte delle rilevazioni in ingresso porta, di default, un punteggio di 5. Le violazioni più piccole portano di meno. E dice che un'installazione dovrebbe mirare a una soglia in ingresso di 5. L'avviso dice che alzare la soglia sopra i default, 5 per le richieste e 4 per le risposte, lascia passare un numero consistente di rilevazioni e ostacola le regole critiche. Nomina quattro classi, tra cui inclusione di file ed esecuzione di comandi, e non le apro. Se la soglia in ingresso è sopra 5, una sola regola da 5 non basta a fermare la transazione. È l'aritmetica della pagina, non una prova che ho fatto io. La stessa pagina dice che alcuni fornitori, e nomina Cloudflare, tengono la soglia di anomaly score ben sopra quei default, e che quella non è un'implementazione corretta del CRS. È una frase del CRS. Non la unisco al punteggio da 1 a 99 della pagina Cloudflare, che è un'altra scheda e un altro numero.
Il punteggio che va al contrario
La documentazione dell'attack score, ultima modifica 16 aprile 2026, ora 17:51 UTC, riletta il 2 novembre, non chiama questo punteggio un modello linguistico. In quella pagina le parole language model non ci sono. La classe di rilevamento classifica ogni richiesta con un algoritmo di machine learning e assegna un punteggio da 1 a 99. Un 1 indica una richiesta quasi certamente malevola. Un 99 indica una richiesta probabilmente pulita. È la direzione opposta al CRS, dove il numero sale con l'anomalia e il blocco scatta quando si raggiunge la soglia. Non ho unito le due scale.
Le Managed Rules, scrive la stessa pagina, confrontano la richiesta con firme di attacchi noti. La pagina dice che hanno un tasso di falsi positivi molto basso. È una frase loro. Non c'è un denominatore, e io non l'ho misurato. Subito dopo dice il limite: una richiesta nota può essere modificata, e fa l'esempio di una prova che cambia gli input, chiamata fuzzing, così il match esatto della firma non scatta. Non descrivo quella prova. L'attack score serve a vedere traffico potenzialmente malevolo che non è un match esatto di nessuna regola delle Managed Rules. Per la protezione massima, la pagina raccomanda di usare entrambi.
La funzione completa è per i clienti Enterprise. I piani Business hanno solo il campo della classe. Non ho aperto il listino e non descrivo prezzi. La sezione Available scores, sulla stessa pagina, elenca un punteggio globale e tre punteggi di classe, tutti da 1 a 99 e tutti Enterprise: iniezione SQL, contenuto inserito nella pagina, iniezione di comandi o esecuzione di comandi. Non ho copiato i nomi dei campi che portano una sigla. Il punteggio globale, scrive la pagina, è ricavato dai punteggi singoli e non è la loro somma. Un globale basso di solito indica punteggi singoli medio-bassi. Un globale alto suggerisce punteggi singoli più alti. Sulla stessa scala, basso vuol dire più sospetto.
La classe ha quattro valori. attack da 1 a 20. likely_attack da 21 a 50. likely_clean da 51 a 80. clean da 81 a 99. Il 100 vuol dire che la richiesta è arrivata al sistema e non è stata valutata: in dashboard la classe si chiama Unscored e non si può usare nelle espressioni. Lo 0, nei dati Logpush, vuol dire che la richiesta non è arrivata a questo stadio. In dashboard lo 0 non compare. La pagina dice anche che il punteggio riconosce e decodifica da solo tre forme, Base64, sequenze di escape Unicode del JavaScript, e la codifica degli indirizzi, nell'URL, negli header e nel corpo. Non descrivo quelle forme.
Bloccare solo perché il punteggio è sotto 50, scrive la pagina, non è consigliato: la fascia da 21 a 50 può includere richieste legittime segnate per errore. Se si vuole bloccare, la pagina propone un taglio più stretto, sotto 20 o sotto 15, oppure altri filtri accanto. L'esempio iniziale per Enterprise è bloccare quando il punteggio è minore o uguale a 20. Per Business l'esempio che ho letto usa la classe attack. Non ho finito il resto di quell'esempio. Non ho misurato un sito.
Dove entra un modello, negli abstract
Il primo abstract è arXiv 2504.08176, versione v1 restituita dall'API il 2 novembre 2026. Pubblicato e aggiornato, nell'API, l'11 aprile 2025. Ho letto l'abstract per intero. Non ho aperto il PDF e non ho cercato una versione successiva fuori da questa risposta. L'abstract dice che i firewall a regole faticano sulle richieste molto offuscate perché le regole vanno aggiornate a mano. Il framework dichiarato usa un modello linguistico per due scopi: produrre richieste, e proporre regole dopo averle provate contro un'applicazione già protetta da un firewall. Non descrivo quei passi e non ho ripetuto l'esperimento. L'abstract riporta percentuali per due modelli. Non le copio. Sono il risultato di un test che non ho fatto, su un'applicazione volutamente fragile, e non sono un tasso del tuo sito.
Il secondo abstract è WAPP, arXiv 2609.06840, versione v1, pubblicato e aggiornato nell'API il 6 settembre 2026. Anche qui solo l'abstract, per intero, e non il PDF. La prima frase è il punto sulle firme: i firewall si appoggiano soprattutto alle signature per le richieste note, e questo può lasciare buchi contro richieste modificate o mai viste. La positive security, scrive l'abstract, impara il traffico legittimo e blocca ciò che esce dal profilo. Imparare dal traffico vivo è rischioso se le richieste malevole finiscono nei dati di training. Il framework descritto combina un filtro di fiducia, una sintesi deterministica di regole, un punteggio di confidenza e una validazione prima dell'applicazione. Sul campo username dell'applicazione di prova che l'abstract chiama DVWA, l'apprendimento non filtrato diventa Degraded con lo 0,2% di traffico avvelenato e Broken con lo 0,5%. Vale per quel campo, in quel test. Non è un tasso del tuo sito. L'abstract aggiunge che un campo di testo libero può accettare input malevoli anche senza avvelenamento. Sul dataset congelato, la configurazione con tutti e sette i segnali porta la resistenza misurata dal 53% al 90%, contro il 62% del confronto che l'abstract chiama Kruegel e Vigna. Non ho aperto quel confronto e non elenco i sette segnali: stanno nel PDF, che non ho letto. Il sintetizzatore deterministico, scrive l'abstract, blocca in modo paragonabile al modello linguistico provato, senza il costo di inferenza. Quindi il modello, in WAPP, è il termine di confronto, non il filtro che la pagina Cloudflare chiama attack score.
Nessuno dei due abstract è un filtro che ho acceso. Nessuno dei due l'ho rifatto. Non sono la somma del CRS e non sono la scala da 1 a 99.
Che cosa non cambia
Un criterio nuovo non chiude i lavori vecchi. Le patch restano patch. Non ho riletto quell'articolo riga per riga oggi. Una regola, uno score o un modello possono comprare tempo su una richiesta. Non aggiornano il componente. Autorizzazione sbagliata, segreti nel repository, backup mai provato: la pagina sull'altro firewall ne parla, e non la rifaccio. Una richiesta legale per il filtro può essere tossica per la logica. La personalizzazione, sulla pagina OWASP, va mantenuta quando l'applicazione cambia, qualunque sia il criterio. Uno score lasciato solo nel log, o un modello di cui nessuno legge gli errori, è un costo. Non è una riduzione.
Se le firme non hanno matchato e sul server c'è già un file che esegue comandi, il lavoro non è più scegliere il criterio. Non ho aperto oggi una guida su quel caso e non ne copio i passi.
Esempio ipotetico
bottega.example è un nome di scuola. Non ho letto una richiesta di quel nome. Non ho misurato un firewall.
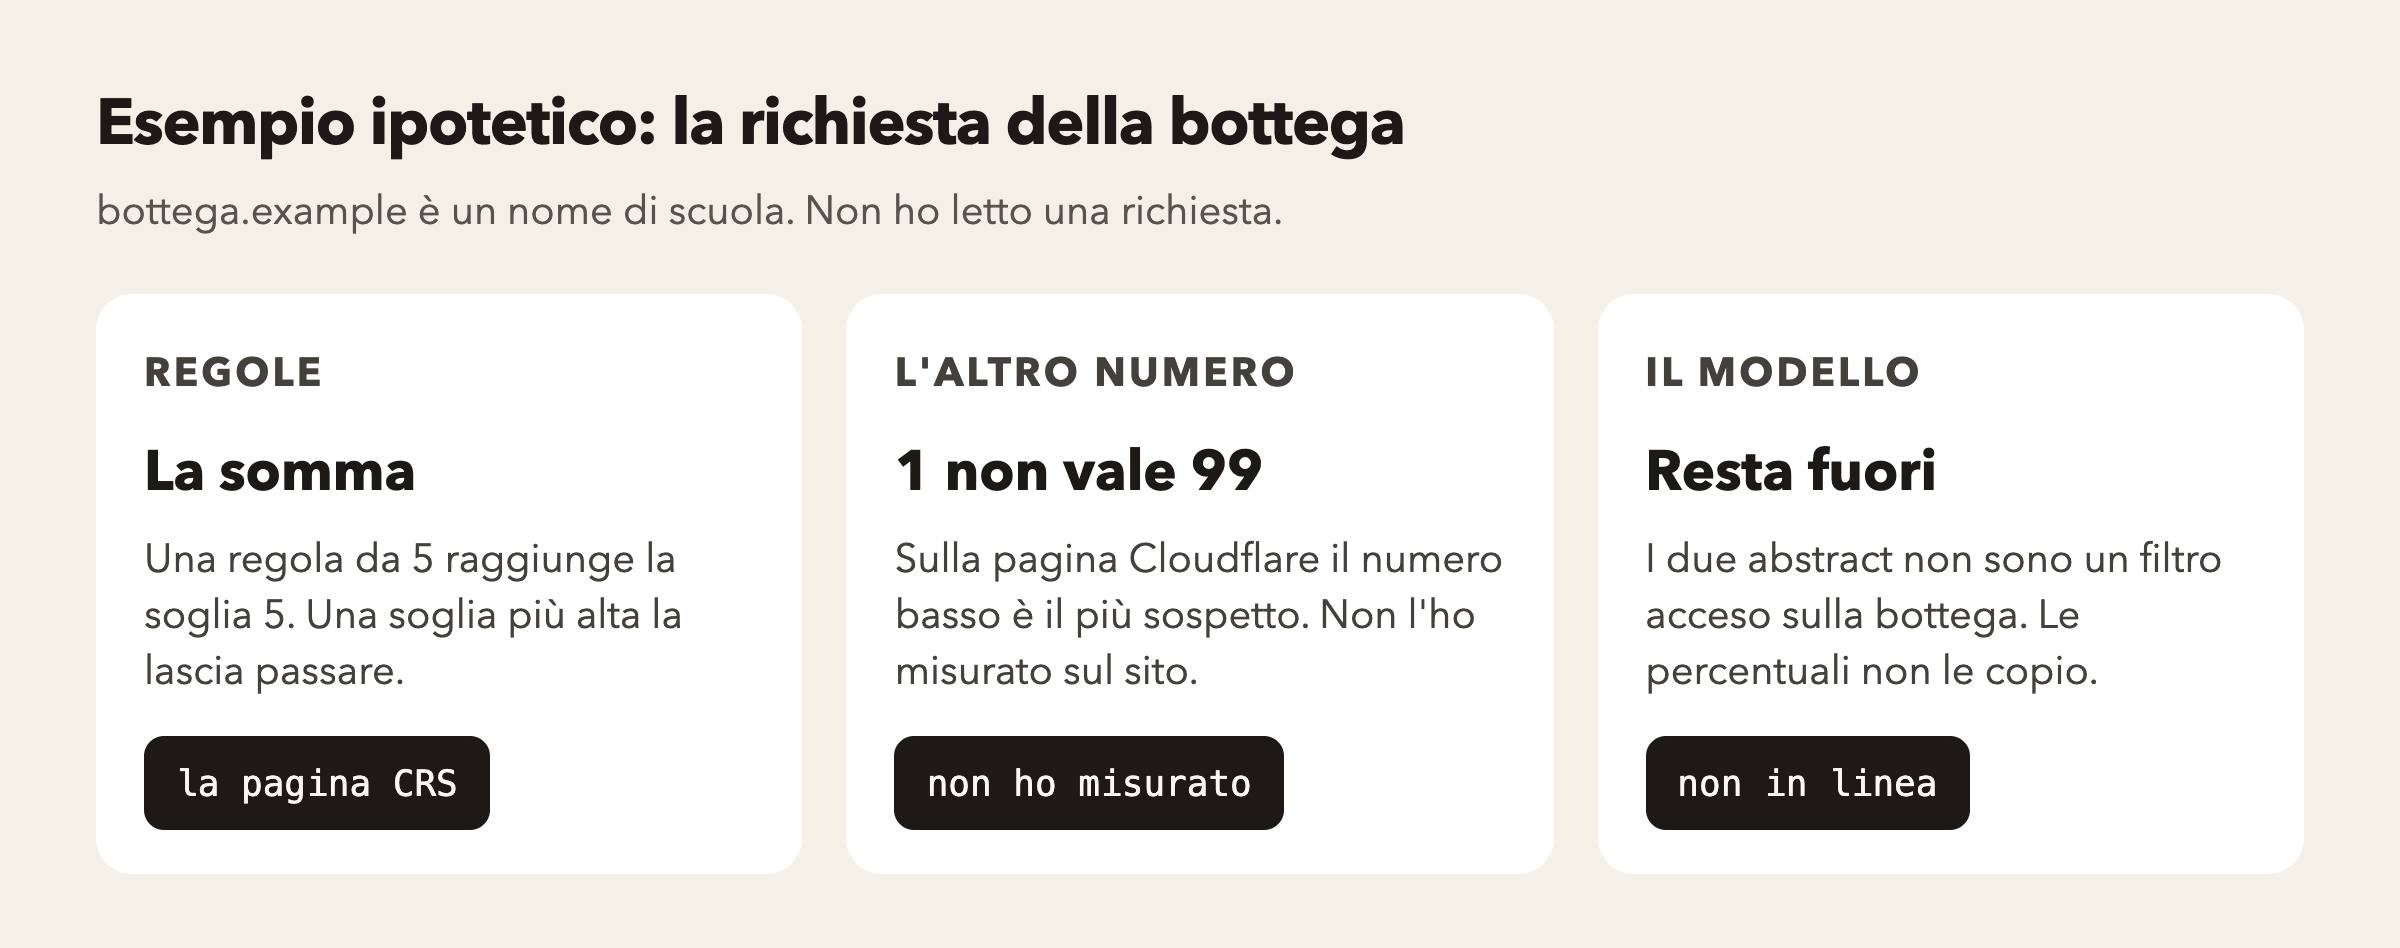
Una richiesta alla bottega che una regola del CRS riconosce prende, secondo quella pagina, un punteggio di 5 se è tra le rilevazioni in ingresso più comuni. Con la soglia 5 che la pagina indica come obiettivo, quella sola regola raggiunge il blocco. Con una soglia più alta, la stessa pagina dice che la regola singola non basta. Non è una misurazione sulla bottega.
Se la stessa richiesta venisse letta con la scala Cloudflare, il numero basso sarebbe il più sospetto e il 99 il più pulito. Un 20 è la soglia iniziale dell'esempio Enterprise, non un 20 del CRS. Le due scale non si sommano. Il modello dei due abstract non entra in questo esempio: non l'ho messo davanti alla bottega, e le percentuali del primo abstract restano fuori.
Che cosa questa pagina lascia stare
Non ho aperto i PDF, né una versione degli abstract oltre la v1 restituita dall'API, né la pagina sul livello di paranoia, né il blocco anticipato, né la tabella delle severità, né le schede ModSecurity, Coraza e WAFEC, né il listino. Non ho riletto riga per riga la pagina su che cosa un firewall blocca, né quella sulle patch. Non ho aperto una guida sul file che esegue comandi. Non ho misurato un sito e non ho acceso un modello. La copertina di questa pagina non è stata cambiata.
Fonti lette il 2 novembre 2026: pagina OWASP sul firewall applicativo, canonical https://community.owasp.org/Web_Application_Firewall. Core Rule Set, anomaly scoring, https://coreruleset.org/docs/2-how-crs-works/2-1-anomaly_scoring/. Cloudflare, attack score, ultima modifica 16 aprile 2026, https://developers.cloudflare.com/waf/detections/attack-score/. Abstract arXiv 2504.08176v1, 11 aprile 2025, e 2609.06840v1, 6 settembre 2026.